EN ES FR ID

Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing Information Guide

  1. Overview to Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing
  2. Main Features
  3. Recent Updates
  4. Deep Dive
  5. Future Outlook

Overview to Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing

LLM Inference Optimization: Async Continuous Batching with CUDA Streams News
Looking for the latest information on Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing? We've gathered comprehensive data, records, and insights about Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing.

Main Features

Deep Dive: Optimizing LLM inference Update
Explore the main sources for Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing.

Recent Updates

Details How to Scale LLM Applications With Continuous Batching! Update
Stay updated on Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing's latest milestones.

LLM Inference Engines: vLLM,  KV Cache, Paged attention and Continuous Batching.
LLM Inference Engines: vLLM, KV Cache, Paged attention and Continuous Batching.
Gentle Introduction to Static, Dynamic, and Continuous Batching for LLM Inference
Continuous Batching - How LLM Servers Keep the GPU Full
LLM Inference Optimization Explained — From 8 Tokens/sec to 50+
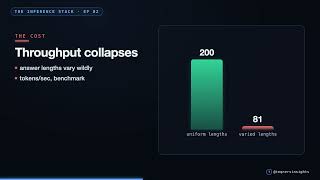
The Waiting GPU: Continuous Batching Explained - 23x From One GPU
Mastering LLM Inference Optimization From Theory to Cost Effective Deployment: Mark Moyou
What is vLLM Efficient AI Inference for Large Language Models
Asynchrony and CUDA Streams | CUDA C++ Class Part 2
LLM Inference Optimization Explained | Quantization, Batching & Parallelism
Continuous Batching Explained | vLLM vs TGI vs SGLang | LLM Inference Optimization & PagedAttention
LLM Optimization Lecture 5: Continuous Batching and Piggyback Decoding

Deep Dive

Data is compiled from public records and verified media reports.

Last Updated: September 14, 2026

Future Outlook

Details Continuous Batching: Optimize LLM Serving Throughput and Latency Update
For 2026, Llm Inference Optimization Continuous Batching And Cuda Stream Asynchronous Processing remains one of the most talked-about information profiles. Check back for the newest reports.

Disclaimer: Disclaimer: All information is compiled from publicly available data, media reports, and analysis. Actual details may vary.

Advertisement